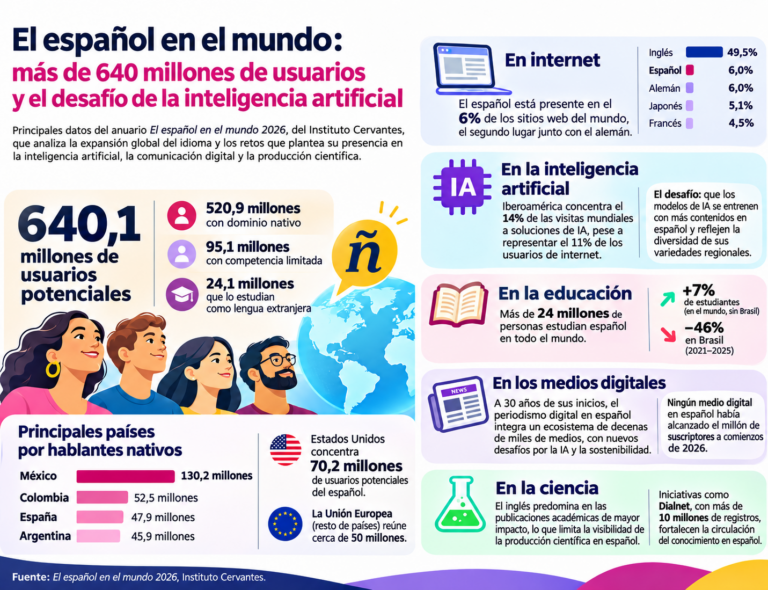
El español alcanzó los 640.064.066 usuarios potenciales en todo el mundo durante 2026, según el nuevo anuario El español en el mundo, elaborado por el Instituto Cervantes. La cifra confirma su posición entre las principales lenguas internacionales, aunque el informe advierte sobre una paradoja: su peso demográfico y cultural todavía no tiene una correspondencia equivalente en las tecnologías de inteligencia artificial, cuyos sistemas de entrenamiento continúan dominados por el inglés.
El estudio del Observatorio Global del Español contabiliza 520,9 millones de personas con dominio nativo, 95,1 millones con competencias limitadas y 24,1 millones que lo estudian como lengua extranjera. De esta manera, el español se mantiene como la tercera lengua del mundo por cantidad de hablantes nativos, detrás del chino mandarín y del hindi.
La expansión del idioma, sin embargo, se produce en un escenario de desaceleración demográfica en los países hispanohablantes. El descenso de las tasas de natalidad y las revisiones de las proyecciones poblacionales indican que su crecimiento futuro dependerá cada vez más de la enseñanza como segunda lengua, de las comunidades migrantes y de su capacidad para ganar presencia en los entornos tecnológicos.
En este último aspecto, el anuario dedica especial atención al avance de la inteligencia artificial generativa, la traducción automática y el desarrollo de modelos de lenguaje capaces de comprender y producir contenidos en las distintas variedades del español.
El español representa el 6% de los sitios web, frente al 49,5% del inglés
El idioma ocupa una posición destacada en Internet. Según los datos de W3Techs correspondientes a enero de 2026, el español se utiliza en el 6% de los sitios web analizados, una proporción similar a la del alemán y superior a las del japonés (5,1%), el francés (4,5%), el portugués (4%) y el chino (1,1%).
Sin embargo, el inglés continúa dominando ampliamente el ecosistema digital, con presencia en el 49,5% de los sitios. La diferencia adquiere una importancia particular con el desarrollo de la inteligencia artificial, porque buena parte de los modelos de lenguaje se entrenan con grandes colecciones de textos obtenidos de Internet.
El informe señala que esta desigualdad puede afectar tanto la calidad de las traducciones como la capacidad de los sistemas para interpretar expresiones regionales, referencias culturales y terminología especializada.
Como antecedente, recuerda que el 92,65% de los datos utilizados para entrenar GPT-3, presentado en 2020, correspondía al inglés. También cita investigaciones sobre Common Crawl, uno de los grandes repositorios de contenido web empleados para desarrollar modelos de lenguaje, donde el inglés representa aproximadamente el 46% del material y el español apenas el 4,6%.
Aunque estas cifras corresponden a conjuntos de datos y modelos específicos, y no permiten describir la composición de todos los sistemas actuales, ilustran la distancia entre la dimensión demográfica del español y su representación en los recursos utilizados por la industria de inteligencia artificial.
La consecuencia potencial es que los asistentes virtuales y traductores automáticos pueden producir textos aparentemente correctos, pero con dificultades para interpretar diferencias entre el español de España, México, la Argentina, Colombia y otros mercados hispanohablantes.
Iberoamérica genera el 14% de las visitas mundiales a servicios de IA
La adopción de inteligencia artificial muestra, al mismo tiempo, una dinámica favorable para los mercados hispanohablantes.
Según cifras de la Comisión Económica para América Latina y el Caribe (Cepal) recogidas en el anuario, Iberoamérica concentra el 14% de las visitas mundiales a soluciones de IA, a pesar de representar aproximadamente el 11% de los usuarios de internet del planeta.
En España, el 41,8% de la población utilizaba mensualmente herramientas de inteligencia artificial generativa a finales de 2025, frente a una media mundial del 16,3%, según datos del Microsoft AI Economy Institute citados por el Cervantes.
En la Argentina, una investigación del Centro de Evaluación de Políticas basadas en la Evidencia (CEPE) y Fundar, realizada en 2025, indica que el 45,5% de los consultados utiliza inteligencia artificial para fines personales y otro 21,8% planea incorporarla. Entre los principales usos figuran la elaboración de resúmenes, las paráfrasis y las traducciones breves, mediante servicios gratuitos o de bajo costo.
El estudio también identifica diferencias en otros mercados. En México, la adopción empresarial de inteligencia artificial muestra un dinamismo mayor que el uso declarado por los ciudadanos, mientras que en Chile más del 80% de las grandes empresas y el 70% de las pymes utilizan estas tecnologías, según datos de Entel Digital citados por el informe.
Para el Instituto Cervantes, la cuestión central no es solamente cuántas personas utilizan inteligencia artificial en español, sino qué participación tendrán las instituciones y empresas hispanohablantes en la producción de los contenidos y datos que alimentan estos sistemas.
El desafío de entrenar inteligencia artificial en español
Uno de los capítulos del anuario, dedicado a la traducción automática, analiza cómo los grandes modelos de lenguaje transformaron esta actividad al permitir traducciones más fluidas y accesibles.
Sin embargo, los investigadores Sergi Álvarez Vidal y Antoni Oliver González advierten que los avances tecnológicos no necesariamente garantizan una representación adecuada de la diversidad lingüística.
El español cuenta con numerosas variedades regionales que incorporan diferencias de vocabulario, construcciones gramaticales y referencias culturales. Cuando los sistemas se entrenan con conjuntos de datos desequilibrados, pueden tender a uniformar esas diferencias o reproducir patrones propios de los idiomas predominantes.
El problema adquiere especial relevancia para los medios de comunicación, las editoriales, las empresas de comercio electrónico y las plataformas audiovisuales, que utilizan cada vez más herramientas automáticas para traducir, adaptar, resumir y distribuir contenidos.
El anuario también destaca la importancia de desarrollar corpus lingüísticos propios, es decir, colecciones estructuradas de textos que permitan entrenar y evaluar sistemas de inteligencia artificial con contenidos representativos de las distintas comunidades hispanohablantes.
Entre las iniciativas mencionadas figura ALIA, el proyecto español de modelos de inteligencia artificial entrenados en castellano y lenguas cooficiales, que forma parte de la estrategia de España para desarrollar infraestructura pública de tecnologías del lenguaje.
La creación de estos recursos aparece vinculada a la posibilidad de reducir la dependencia de plataformas y proveedores externos, y de garantizar que el español mantenga su diversidad en los nuevos sistemas de acceso al conocimiento.
La Argentina, cuarto país hispanohablante y mercado relevante para la IA
México encabeza la clasificación de países hispanohablantes, con 130,2 millones de personas con dominio nativo del español. Le siguen Colombia, con 52,5 millones; España, con 47,9 millones; y la Argentina, con 45,9 millones.
En el caso argentino, el Instituto Cervantes estima una población de 46,5 millones de habitantes para 2026, de los cuales el 98,72% posee dominio nativo del español. Las cifras se basan en proyecciones demográficas elaboradas a partir de información estadística oficial.
La importancia internacional del idioma se extiende mucho más allá de los países donde es lengua mayoritaria. Estados Unidos constituye el principal mercado hispanohablante fuera de ese grupo, con 70,2 millones de hablantes potenciales, incluidos 48,6 millones con dominio nativo y 21,7 millones con competencias limitadas.
La Unión Europea, sin contar España, reúne cerca de 50 millones de hablantes potenciales.
Esta distribución geográfica permite que productos culturales, periodísticos y audiovisuales desarrollados en español puedan circular entre numerosos mercados sin requerir traducciones completas, aunque existan diferencias regionales de consumo y de lenguaje.
Más de 24 millones de estudiantes, con avances en África y retrocesos en Brasil
La enseñanza constituye otra dimensión fundamental de la expansión internacional del idioma. El Instituto Cervantes registra 24,1 millones de estudiantes de español en sistemas educativos, con una concentración importante en Estados Unidos, Europa, Brasil y África.
Estados Unidos reúne aproximadamente 8,9 millones de alumnos. Francia supera los 3,6 millones y Brasil contabiliza cerca de 2,2 millones.
La situación brasileña representa una excepción dentro de la tendencia internacional: la cantidad de estudiantes de español cayó un 46% entre 2021 y 2025, como consecuencia de modificaciones en la legislación educativa que redujeron la presencia del idioma en las escuelas públicas.
Si se excluye Brasil, la cantidad de estudiantes de español creció un 7% en el último período analizado.
África emerge como uno de los principales espacios de expansión, especialmente en Camerún, Costa de Marfil, Benín, Senegal y Gabón, además de Marruecos y Túnez.
China también registra un crecimiento del interés por el español, vinculado con sus relaciones comerciales y diplomáticas con España y América Latina. El anuario dedica una sección completa a la evolución de su enseñanza en el país asiático.
En las plataformas digitales, Duolingo contabiliza más de 72 millones de usuarios que eligieron aprender español, convirtiéndolo en el segundo idioma más estudiado de la aplicación, detrás del inglés. Esta cifra corresponde a usuarios de la plataforma y no debe sumarse al recuento de estudiantes de los sistemas educativos.
Los medios digitales en español también enfrentan los cambios de la inteligencia artificial
El anuario incluye un análisis especial sobre los treinta años del periodismo digital en español, elaborado por Ramón Salaverría, investigador de la Universidad de Navarra.
El trabajo recorre la evolución de los medios digitales desde sus primeras experiencias, entre 1994 y 1996, hasta la consolidación de un ecosistema integrado por varias decenas de miles de publicaciones en ambos lados del Atlántico.
Entre los antecedentes latinoamericanos aparecen los diarios argentinos La Nación y Clarín, junto con otros medios que comenzaron a desarrollar ediciones en internet durante la segunda mitad de los años noventa.
El estudio identifica una transformación significativa en la circulación internacional de noticias en español. Como ejemplo, menciona a Infobae, que desarrolló ediciones dirigidas a distintos mercados latinoamericanos, España y Estados Unidos.
Sin embargo, advierte que el tamaño de la comunidad hispanohablante no se traduce necesariamente en modelos económicos equivalentes a los de los principales medios anglosajones.
A comienzos de 2026, ningún medio digital en español había alcanzado el millón de suscriptores, según Salaverría. El más próximo era Clarín, que había informado contar con 750.000 suscriptores digitales a mediados de 2025. En comparación, The New York Times superaba entonces los doce millones.
El investigador señala que la incorporación de inteligencia artificial en las redacciones puede mejorar la eficiencia y personalizar contenidos, pero también introduce nuevos problemas relacionados con la dependencia tecnológica, la intermediación algorítmica y la sostenibilidad económica.
En particular, advierte sobre un escenario en el que los lectores acceden a información procesada por sistemas de IA sin identificar necesariamente su fuente original.
En este contexto, la credibilidad de las marcas periodísticas y su capacidad para producir información propia pueden convertirse en factores de diferenciación frente a los contenidos generados y distribuidos automáticamente.
La producción científica, otra frontera para el español
La investigación científica representa otro sector donde la dimensión demográfica del español contrasta con su presencia efectiva en los circuitos internacionales.
El anuario señala que el inglés predomina en las publicaciones académicas de mayor impacto y en buena parte de los sistemas de evaluación científica, lo que condiciona las decisiones de investigadores y universidades.
El desarrollo de inteligencia artificial agrega un problema: si los sistemas son entrenados principalmente con publicaciones científicas en inglés, pueden quedar subrepresentadas investigaciones, conceptos y conocimientos producidos en español.
La investigadora Mar Pérez Morillo, autora de uno de los capítulos del anuario, destaca que los corpus científicos constituyen una infraestructura estratégica para que los sistemas de IA comprendan y procesen conocimiento especializado en español.
El informe menciona iniciativas como Dialnet, que reúne más de diez millones de registros académicos, y las redes latinoamericanas de revistas científicas de acceso abierto como herramientas relevantes para ampliar la circulación del conocimiento.
En este escenario, universidades, centros de investigación, bibliotecas, editoriales y medios de comunicación adquieren un papel estratégico como productores de información que puede alimentar las tecnologías del lenguaje.
El Instituto Cervantes concluye que el futuro del español no dependerá únicamente de sumar hablantes, sino de su capacidad para consolidarse como lengua de educación, ciencia, innovación y tecnología.
La cuestión adquiere una nueva dimensión con el avance de la inteligencia artificial: una comunidad de más de 640 millones de usuarios potenciales constituye un mercado de enorme escala, pero su influencia en la economía digital dependerá también de cuánto conocimiento, información y contenido propio consiga incorporar a los sistemas tecnológicos que están transformando la producción y el acceso a la información.
Ayudanos a seguir pensando, buscando y elaborando información para conectar a la sociedad. Si valoras lo que hacemos....

Hacé tu comentario